KI-gestützte Erschließung von Bild- und Objektsammlungen ohne Systemwechsel
Öffentliche Einrichtungen mit großen Bild- und Objektbeständen haben oft dasselbe Problem: Die Digitalisierung ist weit fortgeschritten, die Erschließung nicht. Digitalisate liegen vor, aber ohne Beschreibung, ohne Schlagworte, ohne Ortsangaben. Damit sind sie gespeichert, aber nicht auffindbar. Bei sechs- und siebenstelligen Beständen ist das manuell nicht aufzuholen. Bei drei bis fünf Minuten Bearbeitungszeit je Objekt ergeben zwei Millionen Datensätze über 50 Personenjahre. Wir haben dafür eine Pipeline entwickelt, die bestehende Sammlungs- und Archivsysteme maschinell anreichert, ohne sie abzulösen.
Anbindung: Die Pipeline liest und schreibt über die Schnittstelle des vorhandenen Systems. Im Referenzprojekt ist das FileMaker über OData. Es entsteht keine zweite Datenhaltung und kein Systemwechsel.
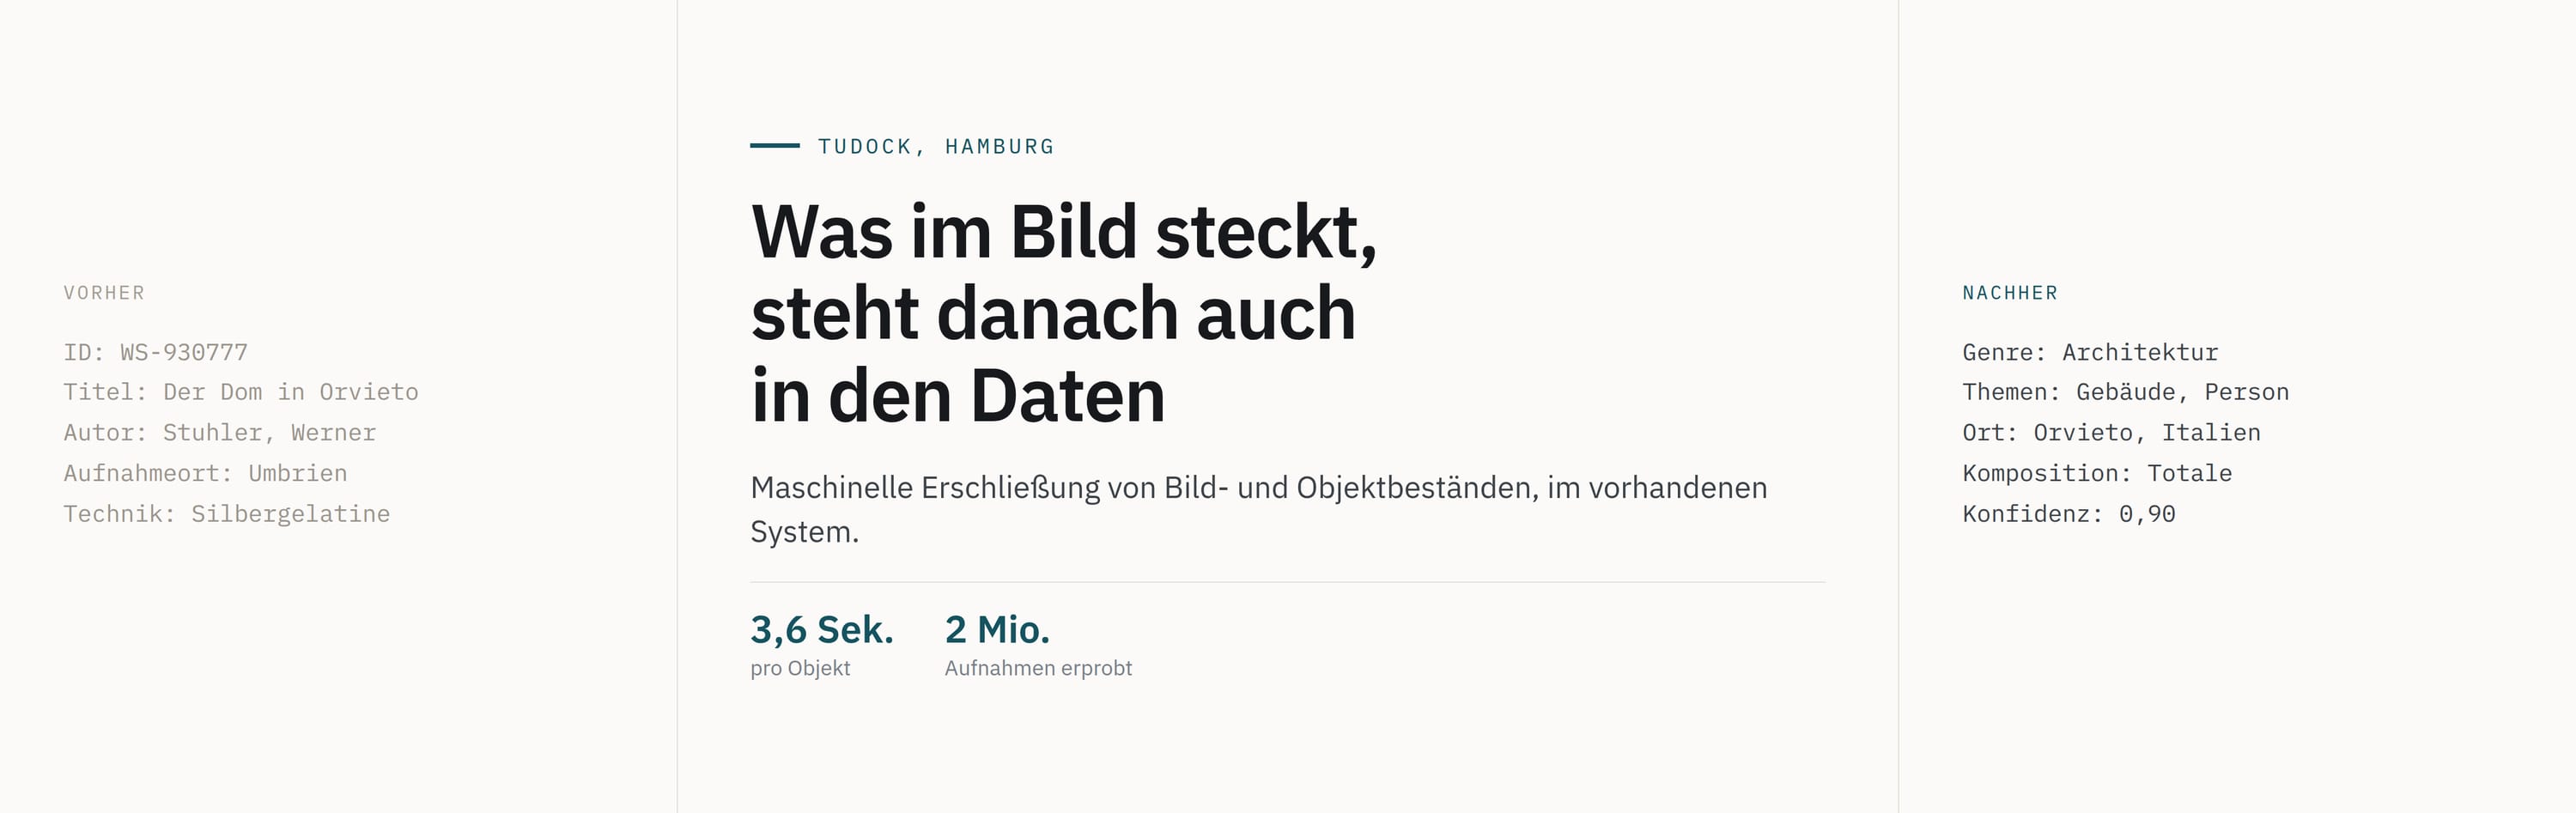
Analyse: Je Objekt werden Beschreibungstext, Genre, Themen-Schlagworte, Ortsangabe, Setting, Technik, Epoche und Bildkomposition erzeugt, dazu ein Konfidenzwert. Die Modellwahl ist gestuft: ein günstiges Bildmodell im Normalfall, automatische Eskalation auf ein stärkeres Modell, wenn die Konfidenz unter der vereinbarten Schwelle liegt.
Validierung: Jedes Ergebnis wird gegen die Taxonomie der Einrichtung geprüft, bevor es zurückgeschrieben wird. Begriffe außerhalb des vereinbarten Vokabulars werden abgewiesen.
Rückschreiben: Die Ergebnisse landen ausschließlich in neuen, dedizierten Feldern. Bestehende Daten werden nie überschrieben. Eine Rückabwicklung bedeutet, diese Felder zu leeren, sonst nichts.
Kontrolle: Ein Dashboard und Prüfberichte erlauben der Fachabteilung stichprobenartige Kontrolle, gefiltert auf die Fälle mit niedriger Konfidenz. Bei sensiblen Beständen, etwa aus kolonialen Kontexten, tritt Einzelfreigabe an die Stelle der Stichprobe.
Betrieb: Wahlweise über Cloud-Modelle, bei denen die Bilder nur zur Analyse übertragen und nicht für Modelltraining verwendet werden, oder über offene Modelle auf eigener beziehungsweise deutscher Infrastruktur, wo der Bestand es verlangt. Beide Varianten sind erprobt.
Wirtschaftlichkeit: Im Referenzprojekt, einem Fotoarchiv mit rund zwei Millionen Aufnahmen, liegt die Verarbeitungszeit bei 3,6 Sekunden je Bild gegenüber drei bis fünf Minuten manuell. Der Gesamtbestand ist parallelisiert in zwei bis vier Wochen durchlaufen statt in über 50 Personenjahren. Die reinen Modellkosten für zwei Millionen Bilder liegen bei rund 600 Euro. Der Aufwand liegt nicht in der Rechenleistung, sondern im Prozess drumherum: Taxonomie, Prüfschleife, Kennzeichnung, Qualitätssicherung.
Auffindbarkeit statt Speicherung: Erschlossen wird nicht nur nach Fachsystematik, sondern zusätzlich in Alltagssprache. Damit finden auch Nutzer etwas, die das Fachvokabular nicht kennen. Genau diese Zugriffsebene fehlt bei rein fachlich erschlossenen Beständen.
Barrierefreiheit: Alternativtexte zu Bildern sind für öffentliche Stellen über die BITV 2.0 gefordert, für bestimmte Dienstleistungen zusätzlich über das Barrierefreiheitsstärkungsgesetz. Bei sechsstelligen Beständen ist das von Hand nicht zu leisten. Die erzeugten Beschreibungen sind dafür verwendbar.
Anschlussfähigkeit: Die Ergebnisse sind so strukturiert, dass sie sich in die Lieferformate der Deutschen Digitalen Bibliothek überführen lassen, direkt oder über einen Aggregator.
Nachvollziehbarkeit: Maschinell erzeugte Angaben stehen in eigenen Feldern und bleiben von fachlichen Inhalten unterscheidbar, auch nach Jahren und auch für Mitarbeitende, die beim Durchlauf nicht dabei waren. Konfidenzwerte und Korrekturen werden protokolliert. Der Abstand zwischen Vorschlag und Freigabe ist die Qualitätskennzahl.
Ehrliche Grenzen: Herkunft, Datierung und Urheberschaft sind aus dem Bild allein nicht verlässlich ableitbar. Aktuelle Modelle ordnen nicht-europäische Objekte messbar häufig europäischen Traditionen zu. Diese Felder gehören in die Prüfschleife, nicht ungeprüft in den Katalog. Die Pipeline ist darauf ausgelegt, solche Fälle sichtbar zu machen, statt sie zu verdecken.
Skalierung: Neue Zugänge laufen automatisch mit, statt zusätzliche Personalkosten zu erzeugen.